Yazıdan Ana Çıkarımlar
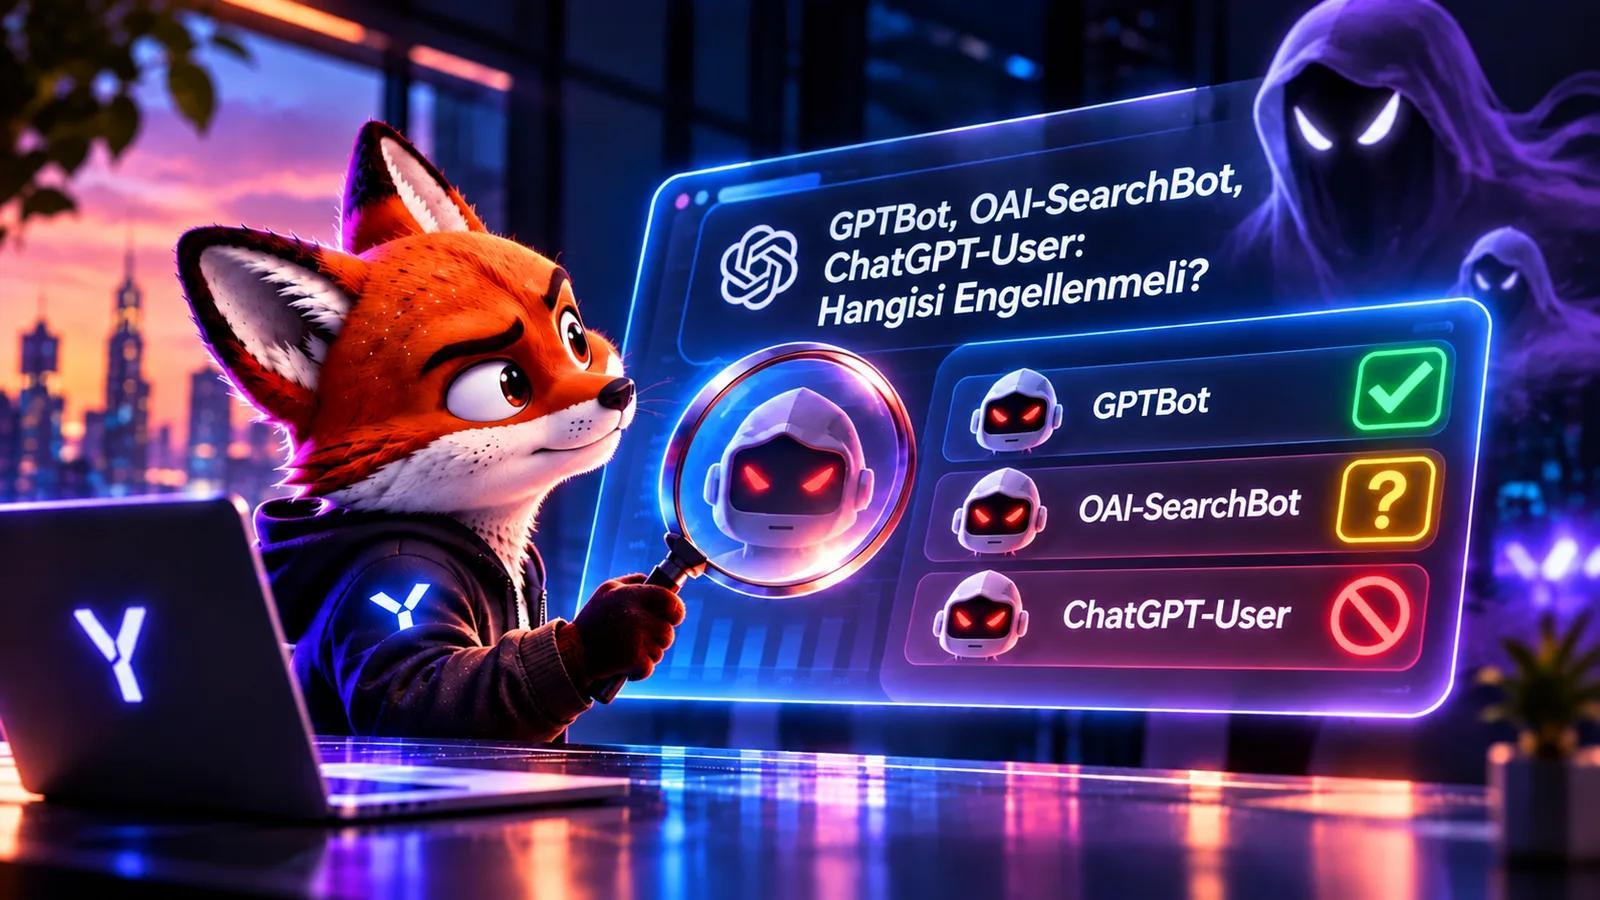
- GPTBot eğitim, OAI-SearchBot ChatGPT arama dizini, ChatGPT-User kullanıcı adına canlı ziyaret içindir; OpenAI'ye göre her ayar birbirinden bağımsızdır.
- OAI-SearchBot'u engelleyen site ChatGPT arama cevaplarında kaynak olarak gösterilmez; GPTBot'u engellemek bunu etkilemez.
- OpenAI, ChatGPT-User için "robots.txt kuralları uygulanmayabilir" diyor; Perplexity-User ve Meta'nın fetcher botu için de benzer not var.
- Cloudflare Radar verisine göre Eylül 2026'da GPTBot'un yapay zeka bot trafiğindeki payı Ocak'a göre yarıya inerken OAI-SearchBot'unki iki katını aştı (SEOmator derlemesi).
- User-agent dizesi taklit edilebilir; gerçek botu OpenAI'nin yayımladığı IP JSON listeleriyle doğrulamak gerekir.
GPTBot, OAI-SearchBot, ChatGPT-User: üçü de OpenAI'ye ait ve log dosyanızda yan yana görünüyor, ama birini engellemekle ötekini engellemek arasında iş açısından büyük fark var. Biri içeriğinizi model eğitimine taşır, biri ChatGPT aramasında kaynak gösterilmenizi sağlar, üçüncüsü ise bir kullanıcı o an sizin sayfanızı sorduğu için gelir. Cloudflare Radar verisini derleyen SEOmator'ın 10 Ekim 2026 tarihli Eylül raporu bu ayrımın neden şimdi önemli olduğunu gösteriyor: yapay zeka botlarında eğitim taraması gerilerken arama amaçlı tarama hızla büyüyor.
GPTBot'u engellemek içeriğinizi eğitimden çıkarır ama ChatGPT aramasındaki görünürlüğünüzü etkilemez; o görünürlüğü OAI-SearchBot belirler. Bu yazıda üç ajanın görevini, robots.txt'ye nasıl uyduklarını, diğer yapay zeka şirketlerindeki karşılıklarını, kopyalanabilir bir robots.txt şablonunu ve sahte bot ayıklamak için IP doğrulamasını anlatıyoruz.
GPTBot, OAI-SearchBot ve ChatGPT-User Ne İş Yapar?
Yönetici için kısa cevap: üç botun üçü de "OpenAI" ama üç farklı kapıdan giriyor. Hangisini kapattığınız, ChatGPT'de markanızın görünüp görünmeyeceğini doğrudan belirliyor. OpenAI'nin resmi bot belgesine göre tablo şöyle:
| Bot | Görevi | robots.txt | Engellerseniz ne olur? | Resmi IP listesi |
|---|---|---|---|---|
| GPTBot | Üretken yapay zeka temel modellerini eğitmek için tarar | Uyar | İçeriğiniz eğitim verisine alınmaz; ChatGPT arama görünürlüğü etkilenmez | openai.com/gptbot.json |
| OAI-SearchBot | ChatGPT'nin arama özelliklerinde siteleri listelemek için tarar | Uyar | ChatGPT arama cevaplarında kaynak olarak gösterilmezsiniz (yalnızca navigasyon linki olarak çıkabilirsiniz) | openai.com/searchbot.json |
| ChatGPT-User | Kullanıcı ChatGPT'de soru sorduğunda veya Custom GPT bir eylem yaptığında sayfayı anlık açar; otomatik tarama yapmaz | OpenAI'ye göre "uygulanmayabilir" | Engel her zaman sonuç vermez; kullanıcının canlı sorusunda sayfanız okunamayabilir | openai.com/chatgpt-user.json |
Belgede iki pratik ayrıntı daha var. Birincisi, ayarlar bağımsızdır: GPTBot'u kapatıp OAI-SearchBot'a izin verebilirsiniz. İkincisi, iki bota da izin verirseniz OpenAI tek bir taramanın sonucunu iki amaç için kullanabilir; robots.txt değişikliğinin arama sistemine yansıması yaklaşık 24 saat sürer. Listede ayrıca OAI-AdsBot da var; bu bot yalnızca ChatGPT'de reklam olarak gönderilen açılış sayfalarını politika uyumu için ziyaret ediyor, eğitimde kullanılmıyor.
Hangi Botu Engellemek GEO'ya Zarar Verir?
GEO, yani yapay zeka cevaplarında görünürlük, artık ölçülebilir bir trafik kanalı. Bu yüzden asıl risk, iyi niyetle yazılmış "tüm yapay zeka botlarını engelle" kuralının OAI-SearchBot'u da kapsaması. O noktada marka ChatGPT aramasında kaynak gösterilme şansını kendi eliyle kapatır.
Trafik verisi de yönün aramaya döndüğünü gösteriyor. SEOmator'ın Cloudflare Radar'dan derlediği Eylül 2026 verisinde GPTBot'un küresel yapay zeka bot isteklerindeki payı Ocak'taki %12,6'dan %6,2'ye indi; OAI-SearchBot %1,7'den %3,6'ya çıktı. Aynı raporda OpenAI isteklerinin içinde arama ve kullanıcı eylemi kaynaklı olanların payı Ocak'ta yaklaşık %19 iken Eylül'de %45'e ulaştı.
📊 İstatistik: Cloudflare Radar'ın 5 Ekim 2026 robots.txt taramasında (4.261 dosya) GPTBot 546 dosyada Disallow kuralıyla anılırken OAI-SearchBot 279 dosyada engellendi, 316 dosyada açıkça izin aldı. SEOmator, "Monthly AI Crawler Report: September 2026", 10.10.2026
Yani site sahipleri ayrımı yavaş yavaş öğreniyor: eğitim botu daha sık kapatılıyor, arama botu daha sık açılıyor. TechnologyChecker'ın 3. çeyrek kapanış analizi de aynı tabloyu veriyor: OpenAI botları arasında izin verilme sayısı engellenme sayısını geçen tek bot OAI-SearchBot.
Burada hassas nokta ChatGPT-User. Aynı taramada 328 dosya bu botu engelliyor, oysa OpenAI kullanıcı tarafından başlatılan bu isteklerde robots.txt'nin uygulanmayabileceğini açıkça yazıyor. Yani o satır, hem beklenen korumayı garanti etmiyor hem de kullanıcının canlı sorusunda sitenizin okunmasını zorlaştırabiliyor.
Diğer Yapay Zeka Şirketlerinin Botları Hangileri?
OpenAI'deki üçlü yapı diğer şirketlerde de benzer şekilde var. Karar verirken her şirketin "eğitim", "arama" ve "kullanıcı adına" ayağını ayrı düşünmek gerekiyor. Aşağıdaki tablo her şirketin kendi resmi belgesinden derlendi:
| Şirket | Eğitim | Arama / dizin | Kullanıcı adına canlı istek | Not |
|---|---|---|---|---|
| OpenAI | GPTBot | OAI-SearchBot | ChatGPT-User | ChatGPT-User için robots.txt uygulanmayabilir |
| Anthropic | ClaudeBot | Claude-SearchBot | Claude-User | Anthropic botlarının robots.txt'ye uyduğunu belirtiyor; Claude-User engeli kullanıcı sorularında görünürlüğü azaltabilir |
| Perplexity | (eğitim için kullanılmadığını belirtiyor) | PerplexityBot | Perplexity-User | Perplexity-User robots.txt'yi "genellikle yok sayar" |
| Google-Extended (yalnızca robots.txt jetonu) | Googlebot | Google-Extended Arama sıralamasını etkilemez; Gemini eğitimini ve Gemini'deki grounding kullanımını kapsar | ||
| Apple | Applebot-Extended (tarama yapmaz) | Applebot | Extended engeli Spotlight, Siri ve Safari'de görünmeyi etkilemez | |
| Meta | meta-externalagent (eğitim ve doğrudan dizinleme) | meta-webindexer | meta-externalfetcher | Fetcher kullanıcı isteğiyle geldiği için robots.txt'yi atlayabilir |
| Common Crawl | CCBot (açık tarama arşivi) | Arşivin sonradan kimler tarafından nasıl kullanılacağı sizin kontrolünüzde değil |
Tablonun ana dersi şu: "Extended" adlı jetonlar ayrı bir tarayıcı değil, mevcut tarayıcının topladığı verinin nasıl kullanılacağına dair bir izin sinyali. Kullanıcı adına gelen ajanlarda ise robots.txt'nin bağlayıcılığı şirketten şirkete değişiyor.
"Eğitimi Kapat, Aramaya Açık Kal" robots.txt Nasıl Yazılır?
İş açısından hedef net: içeriğiniz model eğitimine gitmesin ama ChatGPT, Claude ve Perplexity cevaplarında kaynak olarak görünmeye devam etsin. Bunun için her botu adıyla anan ayrı gruplar yazmak gerekiyor. Aşağıdaki şablon sitenin kök dizinindeki robots.txt dosyasına eklenebilir:
# 1) Eğitim amaçlı botlar: kapalı
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: CCBot
Disallow: /

User-agent: Applebot-Extended
Disallow: /

User-agent: meta-externalagent
Disallow: /

# 2) Yapay zeka arama botları: açık
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# 3) Kullanıcı adına gelen ajanlar: açık
User-agent: ChatGPT-User
Allow: /

User-agent: Claude-User
Allow: /

User-agent: Perplexity-User
Allow: /

Sitemap: https://www.ornek.com/sitemap.xml
Şablonu uygularken üç kontrol yapın. Birincisi, dosyada User-agent: * altında geniş bir Disallow varsa adıyla anılan gruplar o bot için onun yerine geçer; yine de test edin. İkincisi, Anthropic her alt alan adı için ayrı robots.txt gerektiğini hatırlatıyor; blog. veya shop. alt alanlarını unutmayın. Üçüncüsü, değişikliğin OpenAI arama sistemine yansıması yaklaşık 24 saat, Meta tarafında da 24 saate kadar sürebilir.
💡 Uzman notu: Şablona bilerek Google-Extended eklemedik. Google'ın belgesine göre bu jeton yalnızca Gemini eğitimini değil, Gemini uygulamalarında ve Vertex AI'daki "Grounding with Google Search" özelliğinde içeriğinizin cevap anında kullanılmasını da kapsıyor. GEO hedefi olan bir marka için Google-Extended'ı kapatmak, Gemini cevaplarındaki görünürlük konusunda bilinçli verilmesi gereken bir karar; otomatik bir "eğitim engeli" gibi ele alınmamalı.
Sahte GPTBot Nasıl Ayırt Edilir?
User-agent dizesi bir metin satırından ibaret; herhangi bir kazıyıcı kendini "GPTBot" diye tanıtabilir. Güvenlik ve maliyet açısından önemli olan, logdaki isteğin gerçekten OpenAI'den gelip gelmediği. OpenAI bunun için her bot adına ayrı bir IP JSON listesi yayımlıyor ve bu listeler güncelleniyor: ChatGPT-User listesinin oluşturulma zamanı 27 Ekim 2026. Bu yüzden listeyi elle kopyalamak yerine otomatik çekmek gerekiyor.
Gerçek bir GPTBot isteği şu user-agent ile gelir (sürüm numarası değişebilir):
Mozilla/5.0 AppleWebKit/537.36 (KHTML, like Gecko); compatible; GPTBot/1.4; +https://openai.com/gptbotIP doğrulaması için kısa bir Python betiği yeterli:
import ipaddress, json, urllib.request

LISTE = "https://openai.com/gptbot.json"   # searchbot.json, chatgpt-user.json
veri = json.load(urllib.request.urlopen(LISTE))
aglar = [ipaddress.ip_network(p["ipv4Prefix"])
        for p in veri["prefixes"] if "ipv4Prefix" in p]

def gercek_mi(ip: str) -> bool:
    adres = ipaddress.ip_address(ip)
    return any(adres in ag for ag in aglar)

print(gercek_mi("203.0.113.7"))  # örnek IP -> False
Aynı mantık diğer şirketlerde de geçerli: Anthropic botları için claude.com/crawling/bots.json , Perplexity için perplexity.ai/perplexitybot.json ve perplexity.ai/perplexity-user.json yayımlanıyor. Apple ve Common Crawl ise ters DNS doğrulamasını da destekliyor ( *.applebot.apple.com , *.crawl.commoncrawl.org ). Listede olmayan bir IP'den "GPTBot" geliyorsa, o istek OpenAI kurallarına tabi değildir ve güvenlik duvarında ayrıca ele alınmalıdır.
Şirketiniz İçin Doğru Ayar Hangisi?
Tek doğru cevap yok; doğru ayar, içeriğin iş modelindeki yerine bağlı. Aşağıdaki karar tablosu en sık gördüğümüz üç durumu özetliyor:
| Şirket tipi | GPTBot (eğitim) | OAI-SearchBot (arama) | ChatGPT-User (canlı) |
|---|---|---|---|
| Hizmet ve B2B şirketi (içerik pazarlama aracı) | Açık veya kapalı, tercih meselesi | Açık | Açık |
| Yayıncı, ücretli içerik sahibi | Kapalı | Açık, ücretli alanlar ayrıca korunur | Ücretli alanlarda sunucu tarafı erişim kontrolü |
| E-ticaret | Tercih meselesi | Açık (ürün ve kategori sayfaları) | Açık |
Örnek senaryo: Kurumsal yazılım satan bir şirket, hukuk ekibinin talebiyle robots.txt'ye geniş bir yapay zeka botu engeli eklemiş. Pazarlama ekibi birkaç hafta sonra ChatGPT'de kendi kategorisini sorduğunda markanın kaynak olarak çıkmadığını fark ediyor. Log incelemesinde OAI-SearchBot'un aylardır 403 aldığı görülüyor. Çözüm, eğitim botlarını kapalı tutup arama ve kullanıcı ajanlarını açan ayrıştırılmış bir robots.txt ile IP doğrulamalı bir güvenlik duvarı kuralı oluyor. Hukuk ekibinin hassasiyeti korunurken arama görünürlüğü geri açılıyor.
Bu tür bir denetim, Yapay Zeka Firması'nın yapay zeka çözümleri ve GEO hizmetleri kapsamında yaptığı ilk teknik kontrollerden biri. GEO'nun daha geniş çerçevesi için GEO uzmanı nedir, ne iş yapar? yazımıza da göz atabilirsiniz.
Sonuç: Engeli Bota Göre Değil Amaca Göre Verin
GPTBot, OAI-SearchBot ve ChatGPT-User aynı şirketten gelse de üç ayrı iş kararıdır: eğitime katkı, yapay zeka aramasında görünürlük ve kullanıcının canlı sorusuna cevap. Çoğu şirket için mantıklı varsayılan eğitim botunu tercihe göre kapatmak, arama ve kullanıcı ajanlarını açık tutmak ve her kararı IP doğrulamasıyla desteklemektir. Sitenizin robots.txt ve bot erişimi denetimi için bizimle iletişime geçin.
İlgili içerik: Hizmetlerimiz · GEO uzmanı nedir, ne iş yapar? · En iyi GEO ajansı 2026
Kaynaklar
- OpenAI - "Overview of OpenAI Crawlers" (GPTBot, OAI-SearchBot, ChatGPT-User, OAI-AdsBot) · https://developers.openai.com/api/docs/bots
- SEOmator - "Monthly AI Crawler Report: September 2026" (Cloudflare Radar verisi; bot payları, robots.txt taraması 05.10.2026), 10.10.2026 · https://seomator.com/blog/ai-search-optimisation-insights
- TechnologyChecker - "We Analyzed robots.txt Across Cloudflare's Network" (Q3 2026 kapanış güncellemesi), 01.10.2026 · https://technologychecker.io/blog/robots-txt-ai-crawlers-blocking-report
- OpenAI - ChatGPT-User IP listesi (creationTime 2026-10-27) · https://openai.com/chatgpt-user.json
- Anthropic - "Does Anthropic crawl data from the web, and how can site owners block the crawler?" (ClaudeBot, Claude-User, Claude-SearchBot), 07.04.2026 · https://support.claude.com/en/articles/8896518-does-anthropic-crawl-data-from-the-web-and-how-can-site-owners-block-the-crawler
- Perplexity - "Perplexity Crawlers" (PerplexityBot, Perplexity-User) · https://docs.perplexity.ai/guides/bots
- Google - "Google's common crawlers" (Google-Extended) · https://developers.google.com/search/docs/crawling-indexing/google-common-crawlers
- Apple - "About Applebot" (Applebot-Extended) · https://support.apple.com/en-us/119829
- Meta - "Meta Web Crawlers" (meta-externalagent, meta-webindexer, meta-externalfetcher) · https://developers.facebook.com/docs/sharing/webmasters/web-crawlers/
- Common Crawl - "CCBot" · https://commoncrawl.org/ccbot
Sıkça Sorulan Sorular
Hayır. OpenAI'nin resmi belgesine göre GPTBot yalnızca model eğitimi için tarar ve ayarlar birbirinden bağımsızdır. ChatGPT arama sonuçlarında kaynak olarak gösterilip gösterilmemeniz OAI-SearchBot'a verdiğiniz izne bağlıdır. GPTBot'u kapatıp OAI-SearchBot'u açık tutmak, eğitimden çıkıp aramada kalmanın standart yoludur.
Her zaman değil. OpenAI, ChatGPT-User isteklerinin kullanıcı tarafından başlatıldığını ve bu nedenle robots.txt kurallarının uygulanmayabileceğini belirtiyor. Bu bot otomatik tarama yapmaz; bir kullanıcı ChatGPT'de soru sorduğunda veya Custom GPT bir eylem yürüttüğünde sayfayı anlık açar. Erişimi gerçekten kısıtlamanız gereken alanlarda robots.txt yerine sunucu tarafı kimlik doğrulama kullanın.
OpenAI, robots.txt güncellemesinin arama sistemlerine yansımasının yaklaşık 24 saat sürebileceğini belirtiyor. Bu süre izin sinyalinin alınması içindir; sayfalarınızın ChatGPT cevaplarında kaynak gösterilmesi ayrıca içeriğin kalitesine, sorguyla ilgisine ve rekabete bağlıdır. Değişikliği sunucu logunda OAI-SearchBot isteklerinin 200 kodu almasıyla doğrulayabilirsiniz.
Olabilir. Önce isteğin IP adresini OpenAI'nin yayımladığı openai.com/gptbot.json listesiyle karşılaştırın; listede yoksa istek OpenAI'den gelmiyordur ve user-agent taklit ediliyordur. Listede ise robots.txt dosyanızın erişilebilir olduğunu ve değişikliğin üzerinden yeterli süre geçtiğini kontrol edin; OpenAI ayrıca robots.txt'yi çekerken user-agent'a bir robots.txt işareti ekleyebiliyor.
Google'ın belgesine göre Google-Extended, Google Arama'ya dahil olmayı etkilemez ve sıralama sinyali değildir. Ancak bu jeton Gemini modellerinin eğitimini ve Gemini uygulamalarıyla Vertex AI'daki grounding kullanımını kapsar. Yani klasik arama etkilenmez, fakat Gemini cevaplarında içeriğinizin kullanılmasını sınırlayabilirsiniz; GEO hedefiniz varsa bu kararı ayrıca değerlendirin.


